
Bạn cần lấy dữ liệu từ một trang web nhưng chưa biết bắt đầu từ đâu? Thực tế, cách cào dữ liệu website có thể chia thành ba hướng chính: dùng API chính thức, gọi API nội bộ tìm được qua HAR file, hoặc tách trực tiếp mã HTML của trang. Bài viết này giải thích từng cách, so sánh ưu nhược điểm và chỉ ra cách kết hợp với n8n để tự động hóa.
Nội dung xuất phát từ lúc Toán tìm hiểu một công cụ cào dữ liệu và đặt câu hỏi: HAR file là gì, nó có phải một cách cào riêng hay không? Câu trả lời giúp bạn chọn đúng hướng ngay từ đầu.
Mục lục
- Cách cào dữ liệu website: 3 phương pháp chính
- Phương pháp 1: dùng API chính thức
- Phương pháp 2: gọi API nội bộ qua HAR file
- HAR file là gì và cách tạo trong Chrome
- Phương pháp 3: tách HTML từ trang web
- Cách cào dữ liệu website với n8n
- Rủi ro và khi nào không nên cào dữ liệu
- Câu hỏi thường gặp
- Kết luận
Cách cào dữ liệu website: 3 phương pháp chính
Trước hết cần phân biệt nguồn dữ liệu, vì mỗi nguồn quyết định độ ổn định và mức rủi ro của cả hệ thống phía sau. Ba nguồn thường gặp là:
- API chính thức: nền tảng công bố công khai, có tài liệu, key hoặc token rõ ràng.
- API nội bộ: trang web hoặc ứng dụng tự gọi để tải dữ liệu hiển thị, không công bố công khai. HAR file giúp bạn nhìn thấy các API này.
- Mã HTML: tải trang về rồi tách dữ liệu bằng CSS selector hoặc XPath.
Điểm hay nhầm là coi HAR file như một phương pháp thứ ba. Thực ra HAR chỉ là công cụ để phát hiện API nội bộ, tức phương pháp thứ hai.
Phương pháp 1: dùng API chính thức
Đây là hướng nên thử đầu tiên. Bạn đăng ký quyền truy cập, nhận token rồi gọi API theo tài liệu. Ví dụ điển hình là Google Sheets API hay Facebook Graph API.
- Ưu điểm: ổn định, hợp lệ, dữ liệu có cấu trúc rõ ràng và ít bị chặn.
- Nhược điểm: bị giới hạn quyền và loại dữ liệu. Chẳng hạn, Graph API gần như không cho lấy dữ liệu cá nhân của người dùng.
Nếu API chính thức đã đáp ứng nhu cầu, bạn không cần tìm cách nào khác.
Phương pháp 2: gọi API nội bộ qua HAR file
Nhiều trang web hiện đại không nhúng sẵn dữ liệu vào HTML. Thay vào đó, trình duyệt gọi một API phía sau, nhận JSON rồi mới vẽ ra giao diện. Nếu bạn gọi lại được đúng request đó, bạn sẽ có dữ liệu sạch hơn nhiều so với việc tách HTML.
- Ưu điểm: dữ liệu dạng JSON, nhanh, nhẹ, dễ xử lý.
- Nhược điểm: không có cam kết ổn định, thường cần cookie hoặc token đăng nhập, dễ vi phạm điều khoản sử dụng và dễ bị chặn.
Một số dịch vụ như Stevesie cho phép tải HAR file lên, tự dựng lại request và chạy hàng loạt rồi xuất CSV. Theo trang giá của họ vào tháng 10/2026, gói miễn phí giới hạn 10 dòng mỗi ngày, còn các gói trả phí bắt đầu từ khoảng 89,99 USD mỗi tháng. Mức giá có thể thay đổi nên hãy kiểm tra lại trước khi quyết định.
HAR file là gì và cách tạo trong Chrome
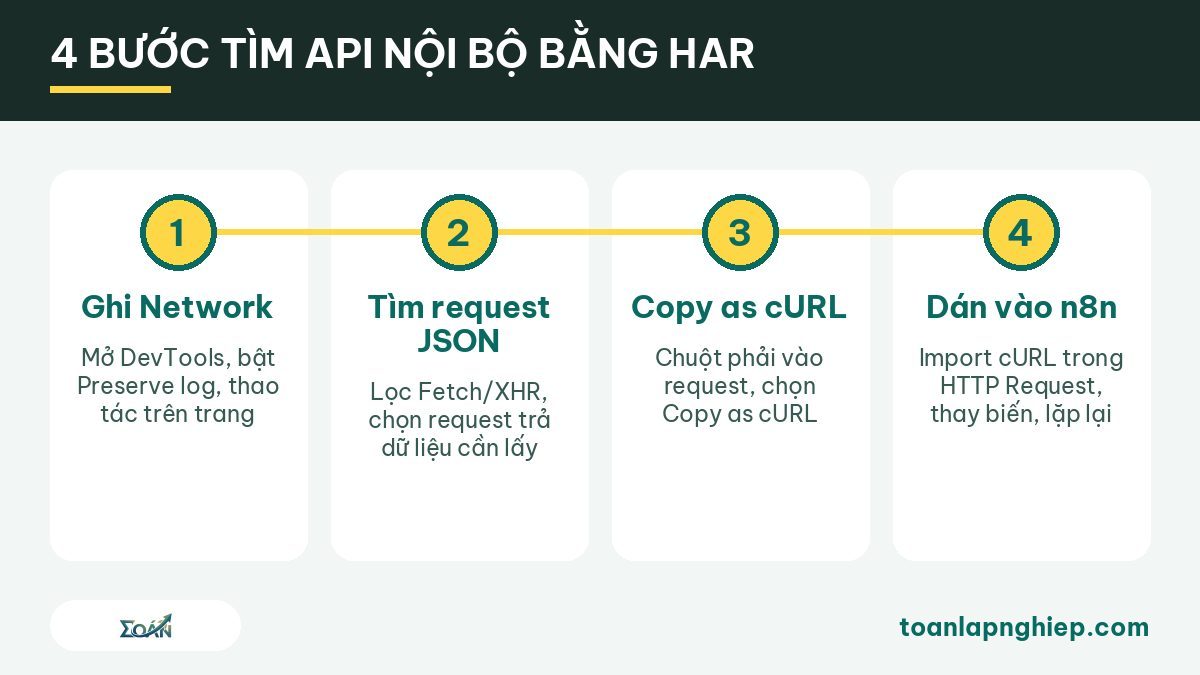
HAR (HTTP Archive) là file định dạng JSON ghi lại toàn bộ request và response mà trình duyệt đã gửi và nhận khi bạn mở một trang. Bên trong có URL, phương thức, header, cookie, tham số, nội dung phản hồi và thời gian tải của từng bước.
Để tạo HAR file trong Chrome, làm theo các bước sau:
- Mở trang cần ghi, nhấn F12 rồi chọn tab Network.
- Tick Preserve log để không mất dữ liệu khi chuyển trang.
- Thao tác trên trang (cuộn, bấm, tìm kiếm) để phát sinh request.
- Bấm chuột phải vào danh sách request và chọn Save all as HAR with content.
Bạn có thể xem thêm hướng dẫn chính thức về tab Network trong tài liệu Chrome DevTools. Lưu ý: file HAR thường chứa cookie và token đăng nhập của bạn, vì vậy đừng gửi cho người khác khi chưa kiểm tra.
Phương pháp 3: tách HTML từ trang web
Khi trang không có API dễ dùng, bạn tải HTML về và tách dữ liệu bằng BeautifulSoup, XPath hoặc CSS selector. Với trang dựng bằng JavaScript, cần thêm trình duyệt tự động như Playwright hoặc Selenium để trang chạy xong rồi mới tách.
- Ưu điểm: làm được với hầu hết trang web.
- Nhược điểm: dễ hỏng khi giao diện thay đổi, chạy chậm hơn và dữ liệu thường lộn xộn hơn.
Cách cào dữ liệu website với n8n
n8n là công cụ tự động hóa quy trình, phù hợp với cả ba phương pháp, nhưng đặc biệt hợp với API nội bộ:
- Trong DevTools, bấm chuột phải vào request cần lấy và chọn Copy as cURL.
- Trong n8n, thêm node HTTP Request và dùng chức năng Import cURL, n8n tự điền URL, header, cookie và body.
- Thay các giá trị cố định bằng biến, ví dụ từ khóa hoặc số trang, rồi dùng vòng lặp hoặc phân trang để chạy nhiều lượt.
- Ghi kết quả sang Google Sheets, cơ sở dữ liệu hoặc công cụ nhắn tin của bạn.
Với API chính thức, n8n thường có sẵn node riêng cho Google Sheets, Airtable hay Facebook. Với tách HTML, bạn dùng node HTML để lấy dữ liệu bằng CSS selector. Riêng trang cần chạy JavaScript thì phải nối thêm dịch vụ bên ngoài như Browserless, Apify hoặc ScrapingBee, vì n8n không tự chạy trình duyệt.
Bạn có thể tham khảo thêm bài kết nối Claude với website để thấy một ví dụ khác về tự động hóa nội dung.
Rủi ro và khi nào không nên cào dữ liệu
- Token hết hạn: workflow đang chạy bỗng báo lỗi 401 hoặc 403, bạn cần cơ chế cập nhật token hoặc thay thủ công định kỳ.
- Giới hạn tốc độ: thêm node Wait giữa các request để tránh bị chặn.
- Rủi ro tài khoản: nếu dùng cookie của tài khoản mạng xã hội, việc gọi hàng loạt có thể khiến tài khoản bị khóa. Không dùng tài khoản chính.
- Bảo mật: lưu cookie và token trong phần Credentials của n8n, không dán thẳng vào workflow.
- Điều khoản và pháp lý: đọc điều khoản của trang nguồn và quy định về dữ liệu cá nhân. Đây là kiến thức tham khảo, không phải tư vấn pháp lý.
Không nên cào khi dữ liệu có API chính thức đáp ứng đủ, hoặc khi dữ liệu là thông tin cá nhân của người khác mà bạn không có cơ sở hợp pháp để sử dụng.
Câu hỏi thường gặp
HAR file có phải một cách cào dữ liệu riêng không?
Không. HAR file là công cụ ghi lại request của trình duyệt để bạn tìm ra API nội bộ. Cách cào thật sự là gọi lại API đó.
Cách cào dữ liệu website nào nên thử đầu tiên?
Thử API chính thức trước, sau đó đến API nội bộ, cuối cùng mới tách HTML. Càng về sau càng dễ hỏng và rủi ro càng cao.
n8n có tự cào được trang dùng JavaScript không?
Không. n8n gọi API và xử lý dữ liệu rất tốt, nhưng với trang cần chạy JavaScript bạn phải nối thêm dịch vụ trình duyệt tự động bên ngoài.
Kết luận
Tóm lại, cách cào dữ liệu website hiệu quả là ưu tiên API chính thức, dùng HAR file để tìm API nội bộ khi cần, và chỉ tách HTML khi không còn lựa chọn khác. Kết hợp với n8n, bạn có thể biến quy trình này thành workflow chạy tự động và ghi thẳng vào bảng tính hoặc hệ thống chăm sóc khách hàng.
Nếu bạn muốn dựng hệ thống thu thập và xử lý dữ liệu riêng cho doanh nghiệp, Toán Lập Nghiệp có thể giúp qua dịch vụ phát triển phần mềm theo yêu cầu. Bạn cũng có thể liên hệ trực tiếp hoặc nhắn Zalo 0393183127 để trao đổi.